智东西 作者 杨京丽 编辑 李水青 智东西9月11日报道,上个月,MiniMax开源通用视频模型 MiniMax H3 。在第三方评测平台Artificial Analysis上,该模型一度 登顶有声视频编辑榜榜首 ,Elo得分达到1130。凭借开放权重、视频生成质量和性价比,H3很快在开发者社区 内衍生出大量适配和新玩法 。 模型开源解决了“能不能部署”的问题,但距离真正真正进入创作流程,中间还有一道 速度门槛 。对于需要反复调整画面的创作者来说,生成速度直接影响创作节奏。 针对这一痛点,RunningHub近期推出并开源了H3视频生成加速方案 H3 Lightning 。在一组5秒视频生成对照测试中,RunningHub将H3的生成耗时 从348.8秒缩短至28.7秒 ,整体推理速度达到基础方案的约 12倍 ,等待时间减少约 92% 。 目前,相关技术方案和复现说明已经在GitHub公开。有多卡设备的用户可以参考方案进行 本地部署 ,没有设备的普通创作者也可以 直接在RunningHub上使用 。 项目开源地址: https://github.com/RH-RunningHub/MiniMax-H3-MultiGPU-Lightning 一、5秒视频不到半分钟生成,等待时间减少92% H3开源后迅速受到创作者关注,但实际部署后,一个问题随之显现:模型权重虽然可以下载,生成速度却依然影响使用体验。 在RunningHub的一组对照测试中,测试环境配备 4张NVIDIA RTX 6000D 专业显卡,生成一段5秒、1344×768分辨率的视频。采用BF16基础方案,完成这一过程需要50步,耗时348.8秒, 接近6分钟 。 RunningHub首先引入 RH后训练加速模型 ,将生成步数 从50步压缩至9步 ,用更少的计算轮次完成视频生成。在这一配置下,生成耗时 缩短至60秒 ,速度达到基础方案的 5.8倍 。 在此基础上,RunningHub进一步 叠加算子和编译优化 ,将生成耗时继续压缩至 28.7秒 。相较基础方案,整体推理速度 提高约12倍 ,等待时间 减少约92% 。 为验证这一能力,智东西也在RunningHub平台进行了测试,我们先让H3生成了一段 5秒的视频 ,内容是一只流浪猫吃猫粮,平台用时 28秒 完成生成,整体过程较为流畅。 ▲5秒视频生成用时28秒(生成过程经倍速处理) 随后,我们提高测试难度: 将视频时长增加到15秒 ,让模型生成一段发生在高级餐厅的都市短剧,角色变多、还加上了台词。 ▲15秒视频生成用时54秒(生成过程经倍速处理) 这段视频用时 约54秒完成 。视频中,一名身穿红裙、披着西装的女子带着两名保镖愤怒地冲进餐厅,宣布“在场的所有人,一个都不许走”,现场气氛迅速变得紧张。实测来看,画面整体完成度较高,角色 动作衔接自然 , 人物表情 能够配合情节变化, 台词、口型与画面基本匹配 ,声音也较为清晰,很有短剧的感觉。 除了文生视频,RunningHub这套加速方案还可用于 多参考图视频生成 。在另一组测试中,RunningHub使用 8张RTX 6000D 显卡,以4步生成15秒、768×1344分辨率的竖屏视频。其中,文生视频耗时约 48秒 ,根据两张参考图生成视频耗时约 73秒 。 值得注意的是,H3 Lightning在提高速度的同时兼顾生成效果, 仍保留BF16数值精度 ,且各项配置均经过组合测试和画质验收。 生成时长缩短,意味着创作者可以更快看到生成结果、调整提示词并尝试下一个版本。对于依赖反复迭代的AI视频创作,单次等待时间的缩短,最终会转化为整个 创作流程效率的提升 。 二、从50步压到9步,三层优化实现12倍提速 从近6分钟缩短至不到30秒,背后是一套覆盖 模型计算和硬件协作的系统优化 。 首先,视频生成需要经过多轮计算逐步形成画面,通常生成步数越多,耗费的时间越长。RH后训练加速模型将 对照测试的生成步数从50步压缩至9步 ,使耗时由348.8秒缩短至60秒,率先 实现5.8倍提速 。 减少生成步骤之后,RunningHub继续 提高剩余计算的执行效率 。 SageAttention2 用于加快注意力计算, Cache-DiT 通过缓存复用部分中间结果,减少后续步骤中的重复计算, torch.compile 则对模型的计算流程进行编译优化,使其以更适合GPU的方式执行。 三项技术与RH后训练加速模型叠加后,5秒视频的生成耗时由60秒进一步 缩短至28.7秒 ,相较BF16基础方案实现 约12倍的整体加速 。 最后一层优化,是让 多张显卡配合 得更好。多卡视频生成不仅需要拆分计算任务,还需要在不同显卡之间交换数据。显卡之间如何分工,会直接影响生成速度、通信开销和显存占用。 针对主

西蒙尼:我们必须撸起袖子加油干 球队进攻火力足但防守需要改进
每次在这里训练,我都能感受到自己的体能提升,健身不仅仅改变了我的外形,更让我变得更加自信和健康!...
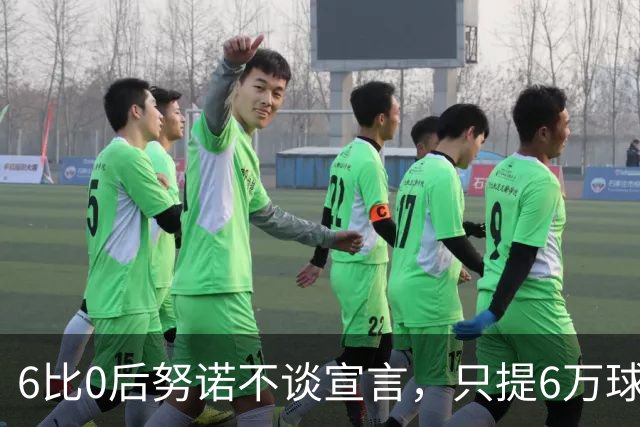
6比0后努诺不谈宣言,只提6万球迷这座球场
每次在这里训练,我都能感受到自己的体能提升,健身不仅仅改变了我的外形,更让我变得更加自信和健康!...